Mise en place d'une classe pour un "mini-jeu"
Une scène avant d'utiliser les entrées clavier, pour apprendre l'instanciation.
Draw Multiple Instances of an Object (Instanciation)
Un draw call est coûteux. Grâce à l’instantiation, Metal peut dessiner un objet plusieurs fois en un seul call (appel).
De plus, le buffer de vertices décrit la forme d'UNE instance, centrée à l'origine.
En C++, cela désigne le fait de créer une instance concrète d’un type. Concrètement, tu passes d’un modèle (classe, template, type) à un objet utilisable en mémoire.
Instanciation classique (sans API graphique)
/// C++ — Exemple — update:18/05/26
struct Tree { float3 position; float scale; float rotation; };

std::vector<Tree> forest;
for (int i = 0; i < 1000; i++)
    forest.push_back({ randomPos(), randomScale(), randomAngle() });

// Boucle CPU — 1000 draw calls — mauvais
for (auto& tree : forest)
    renderer.draw(tree);   // context switch GPU à chaque fois → lent
auto → Tree → chaque élément est de type Tree
Pour chaque tree dans le vecteur std::vector<Tree> nommé forest (pas de copie effectuée).
Le CPU commande. Chaque objet = une décision CPU = un aller-retour vers le GPU.
En MSL — instanciation GPU
/// C++ — Exemple — update:18/05/26
// CPU : upload une seule fois, 1 seul draw call
struct TreeInstance { float3 position; float scale; float rotation; };

auto instanceBuffer = NS::TransferPtr(device->newBuffer(1000 * sizeof(TreeInstance), MTL::ResourceStorageModeShared));

// 1 seul appel — le GPU gère les 1000 instances en parallèle
renderCommandEncoder->drawIndexedPrimitives(MTL::PrimitiveTypeTriangle,
                                            indexCount,
                                            MTL::IndexTypeUInt32,
                                            indexBuffer.get(), 0,
                                            1000   // ← instanceCount
);

// prototype d'une des fonctions fournies par Metal :
void drawPrimitives(MTL::PrimitiveType primitiveType,
                    NS::UInteger vertexStart,
                    NS::UInteger vertexCount,
                    NS::UInteger instanceCount,
                    NS::UInteger baseInstance); // pas d'utilisation de base_instance pour ce ch.
auto → NS::SharedPtr<MTL::Buffer>
Dans un shader
/// MSL — Exemple — update:18/05/26
// Shader — chaque thread = une instance
vertex VertexOut vertex_main(uint             vid [[vertex_id]],
                             uint             iid [[instance_id]], // ← l'équivalent de l'index de boucle
                             constant Vertex* vertices  [[buffer(0)]],
                             constant TreeInstance* instances [[buffer(1)]]  // le std::vector uploadé
){
    TreeInstance inst = instances[iid];  // chaque thread lit SA donnée
    float4 worldPos   = float4(vertices[vid].position * inst.scale + inst.position, 1.0);
    // ...
}
Le CPU itère séquentiellement, le GPU à 1000 cœurs en parallèle. En C++ tu décris une boucle. En MSL tu décris un thread.
Notre shader
Le projet consiste à faire bouger les triangles, les arbres ne bougent pas, le déplacement vaisseau dépend des entrées clavier, les nuages (clouds) bougent tant que la partie est en cours.
Des éléments ne doivent plus être affiché s'ils ont été touchés par le vaisseau. Et nous voulons redimensionner la fenêtre comme bon nous semble.
/// MSL — Game2D.metal — update:18/05/26
#include <metal_stdlib>

#include "../includes/SharedGPU/Mesh_shared.h"

using namespace metal;

struct VertexOutGame2D
{
    float4 position [[position]]; // Structure qui touche au code MSL, aligné 16 bytes GPU → préférable
    float4 color;
};

vertex VertexOutGame2D vertex_main_game2d(uint                      vid         [[vertex_id]],
                                          uint                      iid         [[instance_id]],
                                          constant VertexIn2DMesh*  verts       [[buffer(0)]],
                                          constant float2&          windowSize  [[buffer(1)]],
                                          constant float2*          offset      [[buffer(2)]])
{
    float aspect = windowSize.x / windowSize.y; // aspectRatio généralement ~1.59 à 1.8
    float2 pos   = verts[vid].position; // position locale (forme)
    pos.x        /= aspect;

    VertexOutGame2D out;
    out.position = float4(pos + offset[iid], 0.0, 1.0); // + position monde de l'instance
    out.color    = verts[vid].color; // VertexIn2DMesh donne à VertexOutGame2D
    return out;
}
Le fragment est le même que le chapitre sur le figures et meshes.
vertex_main_game2d() & fragment_main_shapes() sont les noms qu'on a donné aux fonctions de shaders. Attention à ne pas avoir de doublons dans les noms, comme en C++ sans l'utilisation de namespace.
- [[vertex_id]]
- Identifiant par sommet, qui inclut la valeur du sommet de base si une est spécifiée. Le type lors de la déclaration 'uint' ou 'ushort' doit correspondre au type pour déclarer [[base_vertex]]. → Tout comme les indices de nos meshes, ce sont des index qui parcourt des tableaux (arrays).
- [[instance_id]]
- Identifiant par instance, qui inclut la valeur de l'instance de base si une est spécifiée. Doit correspondre avec [[base_instance]].
- [[buffer(0)]]
- Nos 'points' placés dans un espace 2D, défini dans 'Mesh.cpp/.hpp'.
- [[buffer(1)]]
- Données globales partagées par tous les sommets (ici la taille de l'écran). Par convention c'est le slot des uniforms — en 3D ce seront tes matrices de transformation.
- [[buffer(2)]]
- Buffer contenant les positions 2D de chaques instances. Il va nous permettre de dessiner en 1 draw call le même objet, exactement sur là où l'on lui demande. Définit dans 'Game2D.cpp'
- [[stage_in]]
- Le type retourné par le vertex shader — ici VertexOutGame2D — après que le rastériseur l'a interpolé barycentriquement pour chaque fragment
vid, iid, verts, windowSize, offset & in sont simplement les noms qu'on leur a attribué pour l'utiliser dans les fonctions.
uint : Entier non-signé 32 bits / Size 4 bytes / Alignement 4 bytes
ushort : Entier non-signé 16 bits / Size 2 bytes / Alignement 2 bytes (valeur maximum 65 535), nos meshes ont 3 à 90 sommets mais, sur Apple Silicon, les registres GPU sont 32 bits donc tu n'économises rien en perf ni en registres à l'usage.
En pratique, toute l'API Metal (drawPrimitives, drawIndexedPrimitives, …) prend des NS::UInteger / uint32_t en paramètre — rester en uint est ce qu'il nous faut.
Un nouvelle classe :
/// C++ — Game2D.hpp — update:18/05/26
#ifndef Game2D_hpp
#define Game2D_hpp

#include <algorithm> // for std::all_of after C++20

#include "../includes/SharedAPP/InputState.h"

#include "Mesh.hpp"

class Game2D
{
public:
    Game2D(MTL::Device* device, MTL::Library* shaderLibrary,
           MTL::PixelFormat colorPixelFormat, MTL::PixelFormat depthPixelFormat);
    ~Game2D();

    void update(float delta, InputState input); // Mettre à jour l'animation
    void draw(MTL::RenderCommandEncoder* renderCommandEncoder, double timeStamp,
              float delta, simd::float2 windowSize);

private:
    void buildGeometry(MTL::Device* device);
    void buildPipeline(MTL::Device*, MTL::Library*,
                       MTL::PixelFormat colorPixelFormat, MTL::PixelFormat depthPixelFormat);

    NS::SharedPtr<MTL::Buffer>  m_sun;
    NS::SharedPtr<MTL::Buffer>  m_treeTrunk;
    NS::SharedPtr<MTL::Buffer>  m_treeLeaves;
    NS::SharedPtr<MTL::Buffer>  m_ship;
    NS::SharedPtr<MTL::Buffer>  m_cloud;
    NS::SharedPtr<MTL::Buffer>  m_bullet;
    NS::SharedPtr<MTL::Buffer>  m_background;
    NS::SharedPtr<MTL::Buffer>  m_ground;
    NS::SharedPtr<MTL::RenderPipelineState> m_renderPipelineState;
};

#endif /* Game2D_hpp */
/// C++ — Game2D.cpp — update:18/05/26
#include "Game2D.hpp"
Game2D::Game2D(MTL::Device* device, MTL::Library* shaderLibrary,
MTL::PixelFormat colorPixelFormat, MTL::PixelFormat depthPixelFormat)
{
m_levels = {
// Count, Speed, Rate
{ {}, 3, 0.2f, 3.0f },
{ {}, 5, 0.22f, 2.0f },
{ {}, 8, 0.33f, 1.2f },
{ {}, 10, 0.44f, 1.f },
};
buildGeometry(device);
buildPipeline(device, shaderLibrary, colorPixelFormat, depthPixelFormat);
restart();
}
Game2D::~Game2D() {}
void Game2D::buildGeometry(MTL::Device* device)
{
m_background = meshes::triangleRectangleMesh(device, { 0.38f, 0.65f, 0.92f, 1.0f });
m_ground = meshes::groundMesh(device);
m_sun = meshes::circleMesh(device, 0.23f, 64);
m_treeLeaves = meshes::triangleEquilateralMesh(device, { 0.0f, 1.0f, 0.23f, 1.0f }, 0.15f);
m_treeTrunk = meshes::squareMesh(device, { 0.4f, 0.2f, 0.05f, 1.0f }, 0.03f, 0.08f);
m_ship = meshes::triangleEquilateralMesh(device, {}, 0.23f);
m_cloud = meshes::cloudMesh(device, 0.15f, 0.06f, 0.03f);
m_bullet = meshes::squareMesh(device, { 1.0f, 0.0f, 0.0f, 1.0f }, 0.015f, 0.04f);
}
void Game2D::buildPipeline(MTL::Device* device, MTL::Library* shaderLibrary,
MTL::PixelFormat colorPixelFormat, MTL::PixelFormat depthPixelFormat)
{
auto vertexFunction = NS::TransferPtr(shaderLibrary->newFunction(MTLSTR("vertex_main_game2d")));
auto fragmentFunction = NS::TransferPtr(shaderLibrary->newFunction(MTLSTR("fragment_main_shapes")));
auto renderPipelineDescriptor = NS::TransferPtr(MTL::RenderPipelineDescriptor::alloc()->init());
renderPipelineDescriptor->setVertexFunction(vertexFunction.get());
renderPipelineDescriptor->setFragmentFunction(fragmentFunction.get());
renderPipelineDescriptor->colorAttachments()->object(0)->setPixelFormat(colorPixelFormat);
renderPipelineDescriptor->setDepthAttachmentPixelFormat(depthPixelFormat);
NS::Error* error = nullptr;
m_renderPipelineState = NS::TransferPtr(device->newRenderPipelineState(renderPipelineDescriptor.get(), &error));
assert(!error && "Pipeline creation failed");
}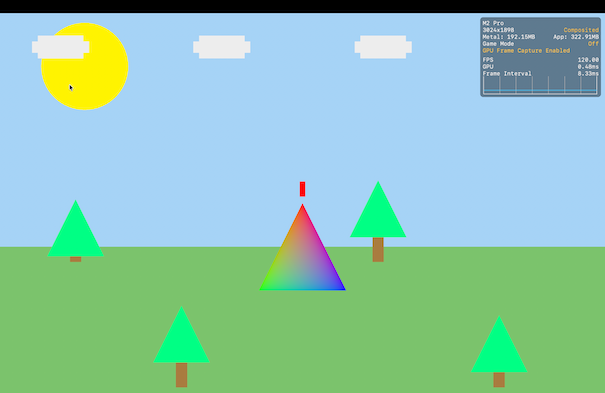
Pour l'instant nous avons appris à afficher des meshes, appliquons-leur des transformations (T x R x S) à chaque frame en 2 dimensions et d'autres paramètres (vitesse, échelle, est-il en vie/à afficher ?). On crée une structure nommée Entity afin de regrouper les données communes à nos entitées (personnage, ennemis, …)
/// C++ — Game2D.hpp — update:18/05/26
struct Entity
{
    simd::float2 position; // une position de base pour chaque
    simd::float2 velocity; // vitesse de déplacement à multiplier par delta
    float scale; // afin de facilement changer la taille des ennemis par rapport au décor
    bool         isAlive; // "Devra-t-il être affiché ?"
};

struct Level
{
    std::vector<Entity> clouds; // plein de copies des 3 données ci-dessus
    int                 cloudCount; // Combien de nuages (la cible du lanceur dans le jeu)
    float               cloudSpeed; // Delta se calcule en float (~0.016f) aussi
    float               cloudSpawnRate;
};

enum class InGame
{
    Waiting, // Like 0,
    Playing, //      1,
    Won,     //      2,
    Lost     //      3
};

struct GamePlay
{   // Notre structure regroupe le gameplay
    InGame m_ingame = InGame::Waiting;
    Entity m_player = {};
    void   reset();
    int    score    = 0;
};
/// C++ — Game2D.hpp — update:18/05/26
public:
void restart();
private:
void spawnLevel(int index);
GamePlay m_gamePlay;
int m_currentLevel = 0;
float m_fireCooldown = 0.f;
std::vector<Level> m_levels;
std::vector<Entity> m_clouds;
std::vector<Entity> m_bullets;Conteneur de séquence qui encapsule les tableaux de taille dynamique
Les éléments sont stockés contiguëment, ce qui signifie que les éléments sont accessibles non seulement par le biais d'itérateurs, mais aussi en utilisant des décalages vers des pointeurs réguliers vers des éléments. Cela signifie qu'un pointeur vers un élément d'un vecteur peut être transmis à n'importe quelle fonction qui attend un pointeur vers un élément d'un tableau.
Le stockage du vecteur est géré automatiquement, étant étendu au besoin. Les vecteurs occupent généralement plus d'espace que les tableaux statiques, car plus de mémoire est allouée pour gérer la croissance future. De cette façon, un vecteur n'a pas besoin de réaffecter à chaque fois qu'un élément est inséré, mais seulement lorsque la mémoire supplémentaire est épuisée. La quantité totale de mémoire allouée peut être interrogée à l'aide de la fonction capacity()
/// C++ — Game2D.cpp — update:18/05/26
void Game2D::restart()
{
    m_gamePlay.reset();
    m_bullets.clear();
    m_fireCooldown = 0.f;
    spawnLevel(0);
}

void GamePlay::reset()
{
    score    = 0;
    m_ingame = InGame::Playing;
    m_player = { simd::float2{0.f, -0.23f}, simd::float2{0.f, 0.f}, 1.0f, true };
}

void Game2D::spawnLevel(int index)
{
    m_currentLevel = index;
    Level& lv = m_levels[index];
    lv.clouds.clear(); // clear(), push_back() et de la même couleur appartient à std::vector
    for (int i = 0; i < lv.cloudCount; i++)
        lv.clouds.push_back({
            { -0.8f + i * (1.6f / lv.cloudCount), 0.89f },
            { 0.f, -lv.cloudSpeed },
            0.1f, true
        });
    m_clouds = lv.clouds;
}

void Game2D::update(float delta, InputState input)
{
    if (m_gamePlay.m_ingame != InGame::Playing)
    {
        if (input.keySpace)
            restart();
        return;
    }

    if (input.keyLeft)
        m_gamePlay.m_player.position.x -= 1.2f * delta * input.speedMultiplier;
    if (input.keyRight)
        m_gamePlay.m_player.position.x += 1.2f * delta * input.speedMultiplier;

    m_gamePlay.m_player.position.x = simd::clamp(m_gamePlay.m_player.position.x, -0.89f, 0.89f);

    m_fireCooldown -= delta;
    if (input.keySpace && m_fireCooldown <= 0.f)
    {
        m_bullets.push_back({ m_gamePlay.m_player.position, { 0.f, .89f }, 0.03f, true });
        m_fireCooldown = 0.25f;
    }

    for (auto& bullets : m_bullets)
    {
        bullets.position += bullets.velocity * delta;
        if (bullets.position.y > 1.1f)
            bullets.isAlive = false;
    }

    for (auto& c : m_clouds)
    {
        if (!c.isAlive)
            continue;
        c.position += c.velocity * delta;

        if (c.position.y < -0.85f)
        {
            m_gamePlay.m_ingame = InGame::Lost;
            return;
        }
    }

    // Collision bullet ↔ cloud (AABB simple)
    for (auto& bullets : m_bullets)
        for (auto& clouds : m_clouds)
            if (bullets.isAlive && clouds.isAlive)
                if (fabsf(bullets.position.x - clouds.position.x) < 0.05f
                    && fabsf(bullets.position.y - clouds.position.y) < 0.05f)
                {
                    bullets.isAlive = false;
                    clouds.isAlive  = false;
                    m_gamePlay.score++;
                }

    auto isDead = [](const Entity& e) { return !e.isAlive; };
    m_bullets.erase(std::remove_if(m_bullets.begin(), m_bullets.end(), isDead), m_bullets.end());


    bool allCloudsDead = std::all_of(m_clouds.begin(), m_clouds.end(), isDead);

    if (allCloudsDead)
    {
        int nextLevel = m_currentLevel + 1;

        if (nextLevel < static_cast<int>(m_levels.size()))
            spawnLevel(nextLevel);
        else
            m_gamePlay.m_ingame = InGame::Won;
    }
}

void Game2D::draw(MTL::RenderCommandEncoder* renderCommandEncoder, double timeStamp, float delta, simd::float2 windowSize)
{
    renderCommandEncoder->setRenderPipelineState(m_renderPipelineState.get());

    auto drawSimple = [&](NS::SharedPtr<MTL::Buffer>& buffer, NS::UInteger vertexCount, simd::float2 position)
    {
        renderCommandEncoder->setVertexBuffer(buffer.get(), 0, 0); // buffer, offset (décalage), index
        renderCommandEncoder->setVertexBytes(&windowSize, sizeof(windowSize), 1);
        renderCommandEncoder->setVertexBytes(&position, sizeof(position), 2);
        renderCommandEncoder->drawPrimitives(MTL::PrimitiveTypeTriangle, NS::UInteger(0), vertexCount);
    };

    auto drawMultiple = [&](NS::SharedPtr<MTL::Buffer>& buffer, NS::UInteger vertexCountPerInstance, simd::float2* positions, NS::UInteger count)
    {   // count - setVertexBytes() - limite 4 Ko → max ~512 instances si tu veux tester les perfs.
        renderCommandEncoder->setVertexBuffer(buffer.get(), 0, 0);
        renderCommandEncoder->setVertexBytes(&windowSize, sizeof(windowSize), 1);
        renderCommandEncoder->setVertexBytes(positions, sizeof(simd::float2) * count, 2);
        renderCommandEncoder->drawPrimitives(MTL::PrimitiveTypeTriangle, NS::UInteger(0), vertexCountPerInstance, count);
    };

    simd::float2 origin = { 0.f, 0.f };
    drawSimple(m_background, 3, origin);

    drawSimple(m_sun, 64 * 3, simd::float2{ -0.72f, 0.72f });

    drawSimple(m_ground, 3, origin);

    for (auto& clouds : m_clouds)
        if (clouds.isAlive)
            drawSimple(m_cloud, 12, clouds.position); // 1 draw call par nuage — pas d'instancing

    simd::float2 trunkPos[] = {
        { -0.75f, -0.23f }, { -0.40f, -0.89f },
        {  0.25f, -0.23f }, {  0.65f, -0.89f },
    };
    simd::float2 leavesPos[] = {
        { -0.75f, -0.13f }, { -0.40f, -0.69f },
        {  0.25f, -0.03f }, {  0.65f, -0.74f },
    };
    drawMultiple(m_treeTrunk,  6, trunkPos,  4); // instancing
    drawMultiple(m_treeLeaves, 3, leavesPos, 4); // instancing

    for (auto& bullets: m_bullets)
        if (bullets.isAlive)
            drawSimple(m_bullet, 6, bullets.position);

    drawSimple(m_ship, 3, m_gamePlay.m_player.position);
}
auto isDead = [](const Entity& e) { return !e.isAlive; }; → type anonyme de lambda généré par le compilateur.
auto drawSimple & auto drawMultiple → type anonyme de lambda généré par le compilateur. Les Le vrais types sont beaucoup plus complexe et n'ont pas de nom accessible
Le capture [&] signifie que toutes les variables utilisées depuis l'extérieur de la lambda sont capturées par référence. On va chercher la case mémoire, on ne créer pas un pointeur vers celle-ci.
/// C++ — Renderer.hpp — update:18/05/26
#include "Game2D.hpp"

private:
    MTL::PixelFormat            m_depthPixelFormat;
    Game2D m_game2d; // après les paramètres qu'elle utilise, car dépend des 4
/// C++ — Renderer.cpp — update:18/05/26
m_pixelFormat(colorPixelFormat), m_depthPixelFormat(depthPixelFormat),
m_game2d(m_device, m_shaderLibrary, m_pixelFormat, m_depthPixelFormat),
/// C++ — Renderer.cpp — update:18/05/26
void Renderer::update(float delta)
{
m_game2d.update(delta, m_input);
} /// C++ — Renderer.cpp — update:18/05/26 — draw()
NS::AutoreleasePool* autoreleasePool = NS::AutoreleasePool::alloc()->init();
update(delta);/// C++ — Renderer.cpp — update:18/05/26 — draw(), place le en dernier, avant endEncoding();
renderCommandEncoder->setViewport(m_viewport);
// ...
m_game2d.draw(renderCommandEncoder, timeStamp, delta, m_windowSize);Aspect Ratio hardcodé
/// MSL — Game2D.metal — update:18/05/26
vertex VertexOutGame2D vertex_main_game2d(uint                      vid         [[vertex_id]],
                                          uint                      iid         [[instance_id]],
                                          constant VertexIn2DMesh*  verts       [[buffer(0)]],
                                          constant float2&          windowSize  [[buffer(1)]],
                                          constant float2*          offset      [[buffer(2)]])
{
    float aspect = 1.0f;
    float2 pos   = verts[vid].position;
    pos.x        /= aspect;

    VertexOutGame2D out; // Copie ta structure sur la puce
    out.position = float4(pos + offset[iid], 0.0, 1.0);
    out.color    = verts[vid].color;
    return out;
}Aspect Ratio fixe peu importe la fenêtre
/// MSL — Game2D.metal — update:18/05/26
vertex VertexOutGame2D vertex_main_game2d(uint                      vid         [[vertex_id]],
                                          uint                      iid         [[instance_id]],
                                          constant VertexIn2DMesh*  verts       [[buffer(0)]],
                                          constant float2&          windowSize  [[buffer(1)]],
                                          constant float2*          offset      [[buffer(2)]])
{
    float aspect = 3.6f; // ratio fixe, peu importe la taille de ta fenêtre
    float2 pos   = verts[vid].position;
    pos          -= float2(0.2, 0.3); // décalé par rapport à ton déclaré en C++
    pos.x        /= aspect;

    VertexOutGame2D out;
    out.position = float4(pos + offset[iid], 0.0, 1.0);
    out.color    = verts[vid].color;
    return out;
}Paramètres : Z = 1, sans depth texture, toujours draw en dernier
Malgré la profondeur, le jeu est toujours en avant plan
/// MSL — Game2D.metal — update:18/05/26
vertex VertexOutGame2D vertex_main_game2d(uint                      vid         [[vertex_id]],
                                          uint                      iid         [[instance_id]],
                                          constant VertexIn2DMesh*  verts       [[buffer(0)]],
                                          constant float2&          windowSize  [[buffer(1)]],
                                          constant float2*          offset      [[buffer(2)]])
{
    float aspect = windowSize.x / windowSize.y;
    float2 pos   = verts[vid].position;
    pos.x        /= aspect;

    VertexOutGame2D out;
    out.position = float4(pos + offset[iid], 0.999, 1.0); // back-face culling désactivé par défault,
    out.color    = verts[vid].color;                    // on utilise l'ordre de draw dans draw()
    return out;
}Nous avons dessiné le jeu en dernier mais avec la profondeur maximale, il doit être alors derrière tout le reste. Cependant la texture de profondeur n'est pas active, il sera donc en premier plan. (On y reviendra après la création de la texture dans laquelle tout ceci est stocké)
Les fonctions de dessin — de drawPrimitives à l'indirect
Tout ce que tu encodes dans un MTL::RenderCommandEncoder n'est que de la configuration : pipeline state, buffers, viewport, depth stencil state. Rien ne se passe. Une seule famille de commandes déclenche réellement le travail du GPU — les fonctions draw*.
Il y en a quatre, et tu n'en utiliseras probablement que deux.
| Famille | Source des sommets | Quand |
|---|---|---|
drawPrimitives |
le buffer, lu en séquence | géométrie triviale, quads plein écran |
drawIndexedPrimitives |
un index buffer | tout le reste — 95 % de tes appels |
drawPatches |
points de contrôle | tessellation hardware |
drawMeshThreadgroups |
généré par un mesh shader | meshlets, pipeline moderne |
Chacune existe aussi en variante indirecte, où les arguments ne viennent plus du CPU mais d'un buffer rempli par le GPU. C'est la dernière section du chapitre, et celle qui compte pour un moteur voxel.
Les types de primitives
Le premier paramètre de toute fonction de dessin dit comment assembler les sommets en formes. Metal en propose cinq — et pas de triangle fan, contrairement à OpenGL.
| Type | Primitives pour N sommets | Usage |
|---|---|---|
PrimitiveTypePoint |
N | particules, debug de nuage de points |
PrimitiveTypeLine |
N / 2 | gizmos, wireframe de debug |
PrimitiveTypeLineStrip |
N − 1 | trajectoires, courbes, contours |
PrimitiveTypeTriangle |
N / 3 | le cas par défaut |
PrimitiveTypeTriangleStrip |
N − 2 | quads, rubans, terrain en bandes |
Un vertex shader qui alimente un dessin en points doit écrire la taille du point dans sa structure de sortie, sinon rien n'apparaît :
struct PointOut
{
    float4 position [[position]];
    float  size     [[point_size]]; // en pixels — obligatoire
};drawPrimitives() — la forme directe
Le GPU lit le vertex buffer du début à la fin, sans réutiliser aucun sommet. C'est ce que fait ton triangle :
/// C++ — Renderer.cpp — buildGeometry()
const VertexIn2DMesh triangle[] = {
    { {-0.89f,  0.89f }, blue  }, // Top-Left
    { { 0.0f,   0.89f }, red   }, // Top-Right
    { {-0.89f, -0.89f }, green }, // Bottom-Left
};
/// C++ — Renderer.cpp — draw()
renderCommandEncoder->setVertexBuffer(m_vertexBuffer.get(), 0, 0);
renderCommandEncoder->drawPrimitives(MTL::PrimitiveTypeTriangle, NS::UInteger(0), NS::UInteger(3));Piège de vocabulaire. Le 0 de setVertexBuffer() est un offset en octets. Le 0 de drawPrimitives() est un vertexStart en sommets. Les deux se cumulent : offset d'abord, puis décalage de vertexStart × stride.
Trois surcharges s'empilent, chacune ajoutant un paramètre :
// 1 — la forme de base
drawPrimitives(primitiveType, vertexStart, vertexCount);

// 2 — N copies de la même géométrie
drawPrimitives(primitiveType, vertexStart, vertexCount, instanceCount);

// 3 — N copies, en démarrant l'index d'instance à baseInstance
drawPrimitives(primitiveType, vertexStart, vertexCount, instanceCount, baseInstance);
Ton quad dessine 6 sommets pour 4 coins
Regarde buildGeometry() de près — Top-Right et Bottom-Left apparaissent deux fois :
/// C++ — Renderer.cpp — l'état actuel
const VertexIn2DMesh square[] = {
    { {-0.5f,  0.5f }, red   },   // TL
    { { 0.5f,  0.5f }, green },   // TR ←
    { {-0.5f, -0.5f }, blue  },   // BL ←
    { { 0.5f,  0.5f }, green },   // TR ← doublon
    { { 0.5f, -0.5f }, black },   // BR
    { {-0.5f, -0.5f }, blue  },   // BL ← doublon
};
Six sommets envoyés, six invocations du vertex shader, pour une forme qui n'a que quatre coins. Deux corrections possibles.
Option A — TriangleStrip. Quatre sommets suffisent, le GPU réutilise les deux derniers pour former le second triangle :
/// C++ — Renderer.cpp — update:13/09/26
const VertexIn2DMesh square[] = {
    { {-0.5f,  0.5f }, red   },   // TL
    { { 0.5f,  0.5f }, green },   // TR
    { {-0.5f, -0.5f }, blue  },   // BL
    { { 0.5f, -0.5f }, black },   // BR
};

// dans draw()
renderCommandEncoder->drawPrimitives(MTL::PrimitiveTypeTriangleStrip, NS::UInteger(0), NS::UInteger(4));
Option B — indexé. Plus verbeux ici, mais c'est la seule option qui monte en charge :
/// C++ — Renderer.cpp — update:13/09/26
const uint16_t squareIndices[] = { 0, 1, 2,   1, 3, 2 }; // TL TR BL — TR BR BL

m_indexBufferQuad = NS::TransferPtr(m_device->newBuffer(squareIndices, sizeof(squareIndices),
MTL::ResourceStorageModeShared));Sur un quad, l'économie est de deux invocations — anecdotique. Sur un chunk voxel de 32³ où chaque sommet est partagé par trois faces, le vertex buffer non indexé fait littéralement le triple de la taille nécessaire, et le vertex shader tourne trois fois plus. Le GPU met en cache les sommets déjà transformés uniquement s'ils portent le même index.
drawIndexedPrimitives()
La séparation sommets / indices est la structure de données standard de toute la 3D. Le buffer de sommets contient chaque position une fois ; le buffer d'indices décrit l'ordre de parcours.
/// C++ — la forme de base, 5 paramètres
renderCommandEncoder->drawIndexedPrimitives(MTL::PrimitiveTypeTriangle,
                                             indexCount,           // nombre d'indices, pas de triangles
                                             MTL::IndexTypeUInt16,
                                             indexBuffer,
                                             indexBufferOffset);   // en octets, multiple de 4
C'est exactement la forme de ton bloc G-Buffer, actuellement commenté :
/// C++ — Renderer.cpp — le bloc gbuffer
gbufferRenderCmdEnc->drawIndexedPrimitives(MTL::PrimitiveTypeTriangle, m_windowQuad.numIndices,
                                            m_windowQuad.indexType, m_windowQuad.indices, NS::UInteger(0));
Le premier paramètre est un nombre d'indices. Pour douze triangles, c'est 36, pas 12. L'erreur donne un modèle tronqué au tiers — symptôme très reconnaissable.
UInt16 ou UInt32 ?
MTL::IndexTypeUInt16
UInt16 → 2 octets par index, plafond à 65 535 sommets par mesh.
Divise par deux la bande passante de l'index buffer. À privilégier par défaut.

MTL::IndexTypeUInt32
UInt32 → 4 octets, plafond à 4 milliards.
Nécessaire uniquement pour un mesh monolithique de plus de 65 535 sommets.
Pour un moteur voxel, ce choix est structurant : un chunk découpé pour rester sous 65 535 sommets peut rester en UInt16 pour toute la scène. C'est autant de bande passante économisée sur chaque frame, gratuitement.
indexBufferOffset doit être un multiple de 4 octets. Si tu empiles les index de plusieurs meshes dans un seul buffer en UInt16, une longueur impaire d'indices casse l'alignement du mesh suivant — pense au padding.
baseVertex et baseInstance — un seul buffer pour toute la scène
La surcharge complète ajoute trois paramètres :
drawIndexedPrimitives(primitiveType, indexCount, indexType, indexBuffer, indexBufferOffset,
                      instanceCount,   // nombre de copies
                      baseVertex,      // décalage ajouté à chaque index (signé !)
                      baseInstance);   // premier numéro d'instance
baseVertex est la clé du mega-buffer : tu concatènes tous les meshes de la scène dans un seul vertex buffer et un seul index buffer, puis chaque mesh se dessine avec ses propres offsets sans jamais appeler setVertexBuffer() à nouveau.
/// C++ — dessiner 3 meshes concaténés sans rebinder un seul buffer
renderCommandEncoder->setVertexBuffer(m_megaVertexBuffer.get(), 0, 0); // une seule fois

for (const SubMesh& sub : m_subMeshes)
{
    renderCommandEncoder->drawIndexedPrimitives(MTL::PrimitiveTypeTriangle,
                                                 sub.indexCount, MTL::IndexTypeUInt32,
                                                 m_megaIndexBuffer.get(), sub.indexOffset,
                                                 1, sub.baseVertex, 0);
}Tout ce que tu règles sur un RenderCommandEncoder reste actif jusqu'au prochain changement ou jusqu'à endEncoding(). Rebinder le même buffer avant chaque draw est du travail CPU pur perte. Ne re-règle que ce qui change réellement d'un draw au suivant.
L'instancing — dessiner 10 000 fois en un appel
Une même géométrie, N transformations différentes. Le vertex shader est invoqué N × vertexCount fois, et reçoit à chaque fois le numéro d'instance.
/// C++ — Renderer.cpp — update:13/09/26
renderCommandEncoder->setVertexBuffer(m_cubeVertices.get(), 0, 0);
renderCommandEncoder->setVertexBuffer(m_instanceBuffer.get(), 0, 2); // une matrice par instance

renderCommandEncoder->drawIndexedPrimitives(MTL::PrimitiveTypeTriangle,
                                             36, MTL::IndexTypeUInt16,
                                             m_cubeIndices.get(), 0,
                                             10000); // instanceCount
/// MSL — Instanced.metal — update:13/09/26
struct InstanceData
{
float4x4 modelMatrix;
float4 color;
};
vertex VertexOut vertex_instanced(VertexIn in [[stage_in]],
constant GlobalUniforms& uniforms [[buffer(1)]],
constant InstanceData* instances [[buffer(2)]],
uint iid [[instance_id]])
{
VertexOut out;
float4x4 model = instances[iid].modelMatrix;
out.position = uniforms.viewProjectionMatrix * model * float4(in.position, 1.0);
out.color = instances[iid].color;
return out;
}Contrairement à Vulkan ou D3D12 où l'identifiant repart de zéro, en MSL instance_id vaut baseInstance + i. Si tu dessines les instances 500 à 599 avec baseInstance = 500, ton shader reçoit 500…599 — pas 0…99.
Pour retrouver un index relatif, récupère aussi base_instance et soustrais. Même règle pour vertex_id, qui inclut baseVertex.
uint iid   [[instance_id]],
uint base  [[base_instance]]
// ... uint local = iid - base;
C'est le mécanisme derrière ton SpriteRenderer : accumuler les sprites dans un buffer pendant la frame, puis vider le lot en un seul flush(). Mille sprites = un draw call, pas mille.
Le dessin indirect — quand le GPU décide
Jusqu'ici, le CPU connaît toujours le nombre de sommets et d'instances au moment de l'encodage. Le dessin indirect casse cette contrainte : les arguments sont lus depuis un buffer, que le GPU peut avoir écrit lui-même une passe plus tôt.
/// C++ — la structure attendue par Metal, définie dans Metal.hpp
struct DrawIndexedPrimitivesIndirectArguments
{
    uint32_t indexCount;
    uint32_t instanceCount;
    uint32_t indexStart;
    int32_t  baseVertex;
    uint32_t baseInstance;
};
/// C++ — Renderer.cpp — update:13/09/26
renderCommandEncoder->drawIndexedPrimitives(MTL::PrimitiveTypeTriangle,
MTL::IndexTypeUInt32,
m_megaIndexBuffer.get(), 0,
m_indirectArgsBuffer.get(), 0); // args lus par le GPULe scénario complet pour ton terrain, en trois passes dans le même command buffer :
Pipeline GPU-driven ;
- Blit
→ fillBuffer(0) remet instanceCount à zéro. C'est exactement l'usage vu au chapitre précédent. - Compute
→ un kernel teste chaque chunk contre le frustum (Gribb–Hartmann) et incrémente instanceCount en atomique pour ceux qui passent, en écrivant leur transformation dans le buffer d'instances. - Render
→ drawIndexedPrimitives indirect lit le compte final. Le CPU n'a jamais su combien de chunks seraient dessinés.
Le gain n'est pas la vitesse de dessin — c'est la disparition totale du coût CPU d'encodage, et du readback qui serait nécessaire pour que le CPU connaisse le résultat du culling.
L'étage suivant est l'Indirect Command Buffer : le GPU n'écrit plus seulement les arguments, mais les commandes de dessin elles-mêmes, y compris les changements de pipeline state et de buffers. Un seul appel CPU exécute une liste construite par un compute shader. C'est la fin logique de la trajectoire, mais commence par l'indirect simple.
Tessellation — drawPatches()
Le GPU subdivise chaque patch selon des facteurs de tessellation, avant le vertex shader. Le cas d'école reste le terrain à LOD continu : une grille grossière subdivisée davantage près de la caméra.
/// C++ — les facteurs viennent d'un buffer, souvent rempli en compute
renderCommandEncoder->setTessellationFactorBuffer(m_tessFactors.get(), 0, 0);
renderCommandEncoder->drawPatches(4,              // points de contrôle par patch (quad)
                                   0, patchCount, nullptr, 0,
                                   1, 0);         // instanceCount, baseInstance
Sur Apple Silicon, la tessellation est largement supplantée par les mesh shaders — mais elle reste plus simple à mettre en place pour un cas purement géométrique.
Mesh shaders — drawMeshThreadgroups()
Le pipeline mesh remplace l'étage vertex par deux étages programmables : un object shader qui décide quoi générer, et un mesh shader qui émet directement des meshlets — petits paquets de triangles avec leurs propres indices.
/// C++ — aucun vertex buffer, aucun index buffer
renderCommandEncoder->drawMeshThreadgroups(MTL::Size(chunkCount, 1, 1),
                                            MTL::Size(32, 1, 1),   // threads par object threadgroup
                                            MTL::Size(64, 1, 1));  // threads par mesh threadgroup
Pour un moteur voxel, c'est la direction naturelle : la géométrie d'un chunk peut être générée entièrement sur le GPU, sans jamais exister en VRAM sous forme de vertex buffer. À garder en tête pour plus tard — ce n'est pas un premier chantier.
Winding et culling — le piège silencieux
Par défaut, Metal considère les triangles en sens horaire comme faces avant, et ne cull rien du tout :
MTL::WindingClockwise  // défaut — face avant en sens horaire
MTL::CullModeNone      // défaut — les deux faces sont dessinées
Tant que CullModeNone est actif, l'ordre de tes sommets n'a aucune importance — c'est pourquoi ton triangle et ton quad fonctionnent sans y penser. Le jour où tu actives le culling pour économiser la moitié des fragments, les meshes dont l'ordre est inversé disparaissent purement et simplement.
/// C++ — Renderer.cpp — quand tu activeras le culling
renderCommandEncoder->setFrontFacingWinding(MTL::WindingCounterClockwise); // convention Blender / glTF
renderCommandEncoder->setCullMode(MTL::CullModeBack);Neuf fois sur dix, ce n'est pas le mesh — c'est la convention. Blender et glTF exportent en sens anti-horaire, Metal attend l'horaire par défaut. Un seul setFrontFacingWinding() règle toute la scène. Dans le doute, repasse temporairement en CullModeNone : si l'objet réapparaît, c'est le winding.
Pièges classiques
Les erreurs à connaître ;
- indexCount confondu avec triangleCount
→ le modèle s'affiche au tiers. Le paramètre est un nombre d'indices : 36 pour un cube, pas 12. - vertexStart en octets
→ c'est un nombre de sommets. L'offset en octets se règle sur setVertexBuffer(). - 65 535 sommets dépassés en UInt16
→ les indices bouclent silencieusement. La géométrie se replie sur elle-même, sans aucune erreur de validation. - instanceCount à 0
→ appel parfaitement valide qui ne dessine rien. Premier réflexe quand un draw indirect n'affiche rien : vérifier le compteur écrit par le compute. - drawPrimitives sans setVertexBuffer
→ crash ou géométrie aléatoire. Le pipeline valide les attributs, pas leur présence à l'exécution. - Winding inversé
→ invisible tant que CullModeNone est actif, fatal dès que le culling est activé. - Point sans [[point_size]]
→ PrimitiveTypePoint sans taille écrite ne rend rien du tout. - indexBufferOffset non aligné
→ multiple de 4 obligatoire. Casse fréquente en empilant des blocs d'indices UInt16 de longueur impaire.
Guide des décisions
Quad, triangle plein écran            → drawPrimitives + TriangleStrip
Mesh importé, chunk voxel             → drawIndexedPrimitives + UInt16
Mesh de plus de 65 535 sommets        → drawIndexedPrimitives + UInt32

Même géométrie, N transformations      → instanceCount + [[instance_id]]
Plusieurs meshes, un seul buffer       → baseVertex + indexBufferOffset
Compte décidé par le GPU               → variante indirecte + fillBuffer(0) en amont

Terrain à LOD continu                  → drawPatches (tessellation)
Géométrie générée sur GPU              → drawMeshThreadgroups (meshlets)

Debug de normales, gizmos              → PrimitiveTypeLine
Particules                             → PrimitiveTypePoint + [[point_size]]
La progression d'un moteur suit toujours le même ordre : d'abord indexer, ensuite instancier, enfin passer en indirect. Chaque étape supprime du travail CPU sans rien changer à l'image produite.